Kaum ein Unternehmen hat seine Applikationslandschaft jemals am Reißbrett entworfen.
Sie ist gewachsen, Jahr für Jahr, Projekt für Projekt, System für System. Ob SAP oder Non-SAP spielt dabei kaum noch eine Rolle, denn fast niemand bewegt sich heute in nur einer technologisch homogenen Welt. In diesem Artikel zeigen wir, wie Sie aus diesem Wildwuchs eine tragfähige Datenstrategie machen: mit Data Mesh als Methode und einem pragmatischen Einstieg, der sich in der Praxis bewährt hat.
Gewachsene Datenlandschaften: typische Symptome fehlender Datenstrategie
Ein ERP hier, ein Fachsystem dort, dazu ein Data Warehouse, Eigenentwicklungen und die eine oder andere Excel-Welt. Jedes System hatte zu seiner Zeit seine Daseinsberechtigung. Zusammen ergeben sie eine Landschaft, die vielen bekannt vorkommen dürfte:
-
Mehrfachpflege: Dieselben Daten werden in mehreren Systemen parallel gepflegt. Das bedeutet doppelten Aufwand und abweichende Stände.
-
Unübersichtlichkeit: Niemand kann verlässlich sagen, welches System für welches Datenobjekt führend ist.
-
Veraltete Tools und komplexe Skripte: Gewachsene Transformationslogik, die nur noch Wenige wirklich durchdringen.
-
Schnittstellen-Wildwuchs: Viele verschiedene Schnittstellen, von denen einige nicht zuverlässig funktionieren.
-
Unklare Verantwortung: Zuständigkeiten für Daten sind nicht eindeutig geklärt.
Das Ergebnis: Ein und dasselbe Datenobjekt lebt in mehreren Systemen und zeigt jeweils eine andere Wahrheit. Das Problem sind dabei selten die einzelnen Systeme, sondern die fehlende Durchgängigkeit über System- und Prozessgrenzen hinweg. Die Folgen sind wenig Transparenz, hoher Abstimmungsaufwand und ein erhöhtes Risiko, Entscheidungen auf Basis unvollständiger oder fehlerhafter Daten zu treffen.
SAP- und Non-SAP-Stack: Warum doppelte Tools ohne klare Rollen Probleme schaffen
Ein Muster, das uns in der Praxis immer wieder begegnet: Im Unternehmen existieren verschiedene Tools, die teilweise dieselbe Funktionalität bieten, und es ist nicht geklärt, wer zuständig ist. Das klassische Beispiel ist der “SAP-BI-Stack” neben einem “Non-SAP-BI-Stack”. Es gibt zwei Werkzeuge für Data Warehousing und Reporting, und unklar bleibt, wann welches genutzt werden soll.
Wie es dazu kommt, ist unterschiedlich:
-
Teilweise gewollt: Ein zweiter Stack wurde bewusst eingeführt, weil er für bestimmte Anwendungsfälle besser passt. Es fehlt aber eine klare funktionale Trennung, also eine Regel, was wo hingehört.
- Teilweise gewachsen: Fachbereiche brauchten schnell Antworten, die zentrale Lösung war zu langsam oder zu schwerfällig, und über die Jahre ist daraus “Schatten-IT” entstanden.
Die Folgen kennen Sie aus den Symptomen oben: Daten werden doppelt gehalten und gepflegt, Kennzahlen weichen voneinander ab, und niemand kann sagen, welche Zahl stimmt. Das eigentliche Problem sind nicht die vielen Tools, sondern die fehlende Verteilung von Aufgaben und Zuständigkeiten.
Die zentrale Frage lautet dann: Wie gehen wir damit um? Fokussieren wir uns auf einen technologischen Stack oder fahren wir bewusst zwei?
Sehen Sie sich die Aufzeichnung unseres Webinars an: "Bridging Business and Analytics: The Plug-and-Play Future of Data Platforms"
Warum eine Datenstrategie wichtiger ist als ein weiteres Tool-Roulette
Egal wie die Antwort ausfällt: Ein weiteres Tool allein löst das Problem nicht. Es wäre im Zweifel nur ein weiteres System in der Landschaft. Was fehlt, ist ein gemeinsames Datenverständnis. Eine Datenstrategie klärt, welche Daten es gibt, wer dafür verantwortlich ist, nach welchen Regeln sie bereitgestellt werden und wo man sie findet. Genau dafür eignet sich Data Mesh: nicht als Technologie, sondern als Methode für das Datenmanagement.
Data Mesh ist ein Ansatz für das Datenmanagement, der die Verantwortung für Daten dorthin verlagert, wo das fachliche Wissen liegt: in die Fachbereiche. Statt alle Daten in einer zentralen Einheit zu sammeln und zu verwalten, organisieren sich die Daten in fachlichen Domänen. Jede Domäne verantwortet ihre Daten und stellt sie anderen als verlässliches Produkt bereit. Gemeinsame Regeln und eine technische Plattform sorgen dafür, dass das Ganze zusammenpasst.
Wichtig ist dabei: Data Mesh ist weder ein Produkt noch eine bestimmte Technologie. Es ist eine Methode, die Organisation, Verantwortung und Architektur zusammen betrachtet und sich mit unterschiedlichen Tools umsetzen lässt, in der SAP-Welt genauso wie außerhalb.
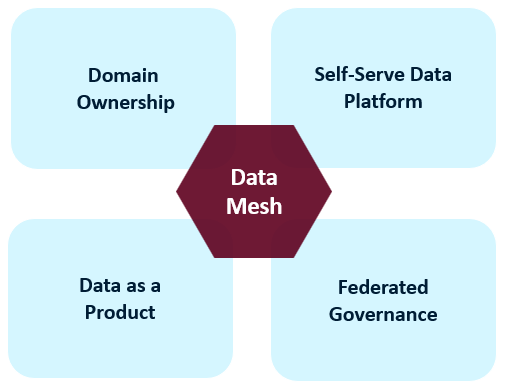
Data Mesh in vier Prinzipien
-
Domain Ownership: Die Fachdomäne kennt ihre Daten am besten und verantwortet sie. Verantwortung wird dezentral verteilt, statt bei einer zentralen IT zu liegen.
-
Data as a Product: Daten werden so bereitgestellt, dass andere sie nutzen können: verständlich, verlässlich und in guter Qualität.
-
Self-Serve Data Platform: Eine technische Plattform macht Domänen unabhängiger von der IT, wenn sie Daten selbständig bereitstellen.
-
Föderierte Governance: Gemeinsame Standards und Richtlinien sorgen dafür, dass Domänen nicht völlig unterschiedlich arbeiten, obwohl die Verantwortung dezentral bleibt.
Gerade im Zwei-Stack-Szenario ist Data Mesh attraktiv, weil es technologieneutral ist. Ein Datenprodukt kann im SAP-Stack liegen, ein anderes in Databricks. Entscheidend sind Verantwortung, Qualität und klare Vereinbarungen.
Data Mesh einführen: ein bewährtes Vorgehen in vier Schritten
Aus unserer Projekt- und Praxiserfahrung hat sich gezeigt: klein starten, einzelne Teile genau anschauen und dort pilotieren.
1. Erwartungen klären und ein bis zwei Domänen auswählen
Starten Sie mit Bereichen, die hohen Business Value haben, viele Systeme und Prozesse berühren und deren Datenprobleme sichtbar sind. Sie dienen später als Blaupause. Klären Sie vor den ersten Gesprächen die Spielregeln: Es geht nicht um ein Audit, nicht um die Bewertung einzelner Personen oder Teams und nicht darum, im Workshop über Systemablösungen zu entscheiden. Es geht um eine gemeinsame Bestandsaufnahme, bei der bekannte Probleme offen benannt und gemeinsam priorisiert werden. Das schafft die Offenheit, die Sie für gute Ergebnisse brauchen.
2. Interviews führen: fachlich und technisch
Gespräche machen sichtbar, was in Systemen allein nicht erkennbar ist. Pro Datenobjekt hat sich dieser Fragenkatalog bewährt:
-
In welcher Applikation und in welchem Prozess liegt das Datenobjekt?
-
Handelt es sich dabei um eine Ist- oder Soll-Entität, um eine primäre oder sekundäre Quelle, um eine interne oder externe Herkunft?
-
Wie steht es um Qualität, Vollständigkeit und Anzahl der Datensätze?
-
Wer ist fachlich verantwortlich (Data Owner), wer pflegt (Data Steward), wer nutzt die Daten?
-
Sind Redundanzen bekannt?
Ergänzend lohnt der Blick auf den Lebenszyklus: Wo entsteht das Datenobjekt? Welche Systeme durchläuft es danach? Wo gibt es Medienbrüche, Mehrfachpflege und fehlende Verantwortlichkeit? Was sind aktuell die größten Schmerzpunkte sowohl in fachlicher als auch technischer Ausrichtung?
3. Bestandsaufnahme: vom knowledge chart zur Entscheidung
Auf dieser Basis entsteht ein schlankes Dashboard. Es zeigt Systeme und Datenobjekte als Netzwerk, filterbar nach Domäne, Ist/Soll und Datenhoheit und vieles mehr.
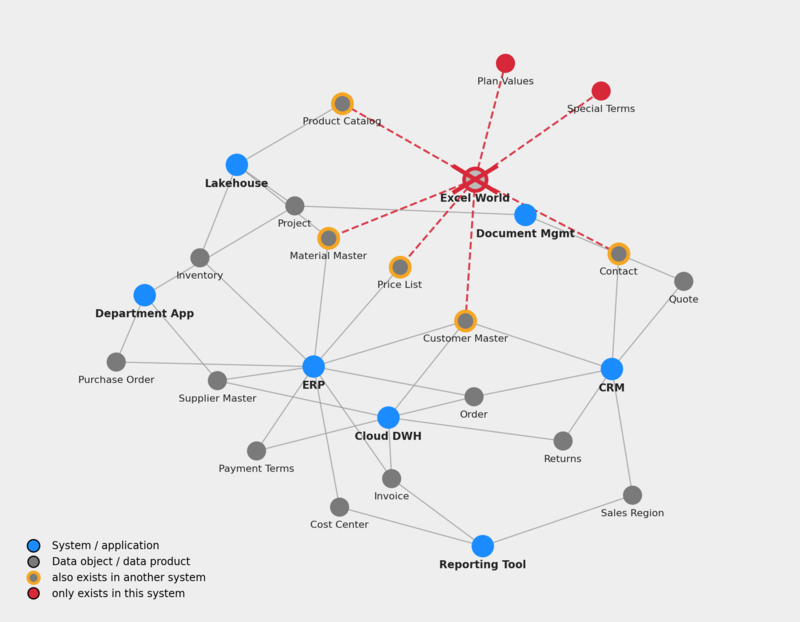
Man sieht auf einen Blick, wo Datenobjekte in mehreren Systemen gepflegt werden, wo ein Owner fehlt und welche Domäne sich als Startpunkt eignet. Auch Was-wäre-wenn-Fragen lassen sich beantworten: Was passiert, wenn wir ein System abschalten? Welche Datenobjekte hätten dann keine Quelle mehr?
So beruhen Entscheidungen zu Stack-Fokus, Priorisierung und Pilotierung auf einem gemeinsamen Bild statt auf Bauchgefühl. Wer zusätzlich messen möchte, wo die Organisation steht, kann ein Reifegradmodell einsetzen und den aktuellen Reifegrad dem angestrebten Ambitionslevel gegenüberstellen. Daraus lassen sich wiederum Maßnahmen ableiten.
4. Skalierung wählen, pilotieren, lernen
Für den weiteren Ausbau gibt es drei typische Wege:
-
Sequenzieller Ausbau: Domäne für Domäne, mit vollständiger Analyse. Das Risiko ist gering und die fachliche Grundlage sauber, aber die Umsetzung ist langsam und der technische Mehrwert verzögert sich.
-
Paralleler Aufbau (unsere Empfehlung): Die drei Säulen (Domänen mit Rollen, Data Hub, Enterprise Data Catalog) entstehen gleichzeitig mit zwei Domänen als Vorreitern. Das bringt schnell sichtbaren Mehrwert, reduziert früh Schmerzpunkte wie Doppelerfassung und ermöglicht iteratives Lernen. Der Preis: Die übrigen Domänen sind noch nicht tief analysiert.
- Vollständige Transformation: Alle Domänen gleichzeitig. Das liefert sofort ein ganzheitliches Zielbild, bedeutet aber hohen Initialaufwand, hohes Risiko und wenig Flexibilität.
Für die technische Umsetzung hängt das Vorgehen davon ab, wie weit die Anforderungen und die Technologieauswahl bereits konkretisiert sind. Bestehen hier noch offene Fragen, kann ein Proof of Concept (PoC) helfen, mögliche Lösungen wie SAP Datasphere oder Databricks sowie einen Enterprise Data Catalog unter realistischen Bedingungen zu erproben. Sind die Anforderungen und der Technologie-Stack hingegen bereits definiert, kann es sinnvoller sein, direkt mit der Umsetzung zu beginnen.
Für die erste Data Domain bilden Interviews die Grundlage der Analyse. Bei der Übertragung auf weitere Domänen lässt sich der Aufwand reduzieren: Ein bereits etablierter Enterprise Data Catalog kann durch die vorhandenen Metadaten einen ersten Überblick über Datenbestände und Zusammenhänge liefern und so die anschließende Analyse gezielt unterstützen.
Diesen Ansatz haben wir auch in einem Vortrag auf dem DSAG-Jahreskongress 2026 vorgestellt - die wichtigsten Erkenntnisse des Kongresses finden Sie in unserem Rückblick auf den DSAG-Jahreskongress 2026. Aus unserer Projekt- und Praxiserfahrung hat sich gezeigt: klein starten, einzelne Teile genau anschauen und dort pilotieren.
Data Hub und Enterprise Data Catalog: die technische Seite
Data Hub statt Flickenteppich. Ein Data Hub ist mehr als ein klassisches Data Warehouse: Er integriert Daten aus den dezentralen Domänen, stellt eine einheitliche Sicht bereit und unterstützt moderne Muster wie Lakehouse und Data Products. Wichtig im Data-Mesh-Kontext: Der Hub ist die technische Plattform, nicht der zentrale Owner. Die Verantwortung bleibt in den Domänen. Ob SAP Business Data Cloud, Databricks, Microsoft Fabric oder Dremio die richtige Basis ist, hängt von Ihrer Situation ab.
In unserem Whitepaper vergleichen wir vier Plattformen anhand von 18 Dimensionen: Laden Sie hier das Whitepaper herunter.
Enterprise Data Catalog als zentrale Orientierungshilfe. Während das Dashboard aus der Ist-Analyse (siehe oben) den aktuellen Stand abbildet, schafft ein Enterprise Data Catalog eine langfristige Übersicht über die Datenlandschaft. Er hilft dabei, drei zentrale Fragen zu beantworten: Wo sind welche Daten zu finden? Was bedeuten sie fachlich? Und wer ist dafür verantwortlich?
Dazu gehören unter anderem fachliche und technische Metadaten, ein Business-Glossar, die Zuordnung von Datenverantwortlichkeiten sowie die Nachverfolgung von Datenflüssen über Systemgrenzen hinweg (Data Lineage). Ergänzend können Funktionen für Datenqualitätsmonitoring, Governance-Prozesse und rollenbasierte Zugriffsregelungen zum Einsatz kommen.
Während ein Data Hub vor allem darauf abzielt, Daten zusammenzuführen, redundante Datenhaltung zu reduzieren und manuelle Schnittstellen zu vermeiden, schafft der Enterprise Data Catalog Transparenz über Datenbestände, Zuständigkeiten und deren Zusammenhänge. Dadurch lassen sich Abstimmungsaufwände reduzieren und Daten gezielter auffinden und nutzen.
Unsere Empfehlungen
-
Transformation und Datenmanagement zusammen denken. Steht ohnehin eine Systemmigration an, etwa eine ERP-Umstellung, ist das der beste Zeitpunkt, die Datengrundlage mitzuplanen.
-
Mit geschäftsrelevanten Domänen starten. Dort ist der Nutzen sichtbar und der Lerneffekt am größten.
-
Governance, Transparenz und Plattform zusammen denken. Ein modernes Datenmanagement entsteht durch das Zusammenspiel von Architektur (Data Hub), Organisation (Domänen, Rollen, Governance) und Transparenz (Enterprise Data Catalog), nicht durch einzelne Maßnahmen.
Datenmanagement mit Data Mesh: Unser Fazit
Historisch gewachsene Applikationslandschaften lassen sich nicht über Nacht ersetzen, und das müssen sie auch nicht. Ob ein Stack oder zwei: Wer Systeme und Organisation ehrlich analysiert und klein startet, trifft die Entscheidung auf einer tragfähigen Grundlage. Data Mesh liefert dafür den methodischen Rahmen mit klarer Verantwortung in den Fachbereichen, Daten als Produkten und gemeinsamen Spielregeln, unabhängig davon, ob Ihre Systeme aus der SAP-Welt stammen oder nicht.
Sie möchten Ihre gewachsene Datenlandschaft strukturieren oder wissen nicht, wie Sie mit einem zweiten Stack in den Fachbereichen umgehen sollen? Ob Bestandsaufnahme, Datenstrategie, Governance oder PoC mit SAP Datasphere, Databricks oder einem Enterprise Data Catalog: Unser Expertenteam unterstützt Sie gerne.