Skip to content
NextLytics
Megamenü_2023_Über-uns

Shaping Business Intelligence

Ob clevere Zusatzprodukte für SAP BI, Entwicklung aussagekräftiger Dashboards oder Implementierung KI-basierter Anwendungen - wir gestalten zusammen mit Ihnen die Zukunft von Business Intelligence. 

Megamenü_2023_Über-uns_1

Über uns

Als Partner mit tiefem Prozess-Know-how, Wissen der neuesten SAP-Technologien sowie hoher sozialer Kompetenz und langjähriger Projekterfahrung gestalten wir die Zukunft von Business Intelligence auch in Ihrem Unternehmen.

Megamenü_2023_Methodik

Unsere Methodik

Die Mischung aus klassischem Wasserfallmodell und agiler Methodik garantiert unseren Projekten eine hohe Effizienz und Zufriedenheit auf beiden Seiten. Erfahren Sie mehr über unsere Vorgehensweise.

Produkte
Megamenü_2023_NextTables

NextTables

Daten in SAP BW out of the Box bearbeiten: Mit NextTables wird das Editieren von Tabellen einfacher, schneller und intuitiver, egal ob Sie SAP BW on HANA, SAP S/4HANA oder SAP BW 4/HANA nutzen.

Megamenü_2023_Connector

NextLytics Connectoren

Die zunehmende Automatisierung von Prozessen erfordert die Konnektivität von IT-Systemen. Die NextLytics Connectoren ermöglichen eine Verbindung Ihres SAP Ökosystems mit diversen open-source Technologien.

IT-Services
Megamenü_2023_Data-Science

Data Science & Engineering

Bereit für die Zukunft? Als starker Partner stehen wir Ihnen bei der Konzeption, Umsetzung und Optimierung Ihrer KI-Anwendung zur Seite.

Megamenü_2023_Planning

SAP Planning

Wir gestalten neue Planungsanwendungen mithilfe von SAP BPC Embedded, IP oder  SAC Planning, die einen Mehrwert für Ihr Unternehmen schaffen.

Megamenü_2023_Dashboarding

Business Intelligence

Mit unserer Expertise verhelfen wir Ihnen auf Basis von Tableau, Power BI, SAP Analytics Cloud oder SAP Lumira zu aussagekräftigen Dashboards. 

Megamenü_2023_Data-Warehouse-1

SAP Data Warehouse

Planen Sie eine Migration auf SAP HANA? Wir zeigen Ihnen, welche Herausforderungen zu beachten sind und welche Vorteile eine Migration bringt.

Business Analytics
Megamenü_2023_Procurement

Procurement Analytics

Transparente und valide Zahlen sind vor allem in Unternehmen mit dezentraler Struktur wichtig. SAP Procurement Analytics ermöglicht die Auswertung von SAP ERP-Daten in SAP BI.

Megamenü_2023_Reporting

SAP HR Reporting & Analytics

Mit unserem Standardmodell für Reporting von SAP HCM mit SAP BW beschleunigen Sie administrative Tätigkeiten und stellen Daten aus verschiedenen Systemen zentral und valide zur Verfügung.

Megamenü_2023_Dataquality

Data Quality Management

In Zeiten von Big Data und IoT kommt der Vorhaltung einer hohen Datenqualität eine enorm wichtige Bedeutung zu. Mit unserer Lösung für Datenqualitätsmanagement (DQM) behalten Sie stets den Überblick.

Karriere
Megamenü_2023_Karriere-2b

Arbeiten bei NextLytics

Wenn Du mit Freude zur Arbeit gehen möchtest und dabei Deine berufliche und persönliche Weiterentwicklung nicht zu kurz kommen soll, dann bist Du bei uns genau richtig! 

Megamenü_2023_Karriere-1

Berufserfahrene

Zeit für etwas Neues? Gehe Deinen nächsten beruflichen Schritt und gestalte Innovation und Wachstum in einem spannenden Umfeld zusammen mit uns!

Megamenü_2023_Karriere-5

Berufseinsteigende

Schluss mit grauer Theorie - Zeit, die farbenfrohe Praxis kennenzulernen! Gestalte bei uns Deinen Einstieg ins Berufsleben mit lehrreichen Projekten und Freude an der Arbeit.

Megamenü_2023_Karriere-4-1

Studierende

Du möchtest nicht bloß die Theorie studieren, sondern Dich gleichzeitig auch praktisch von ihr überzeugen? Teste mit uns Theorie und Praxis und erlebe wo sich Unterschiede zeigen.

Megamenü_2023_Karriere-3

Offene Stellen

Hier findest Du alle offenen Stellenangebote. Schau Dich um und bewirb Dich - wir freuen uns! Falls keine passende Stelle dabei ist, sende uns gerne Deine Initiativbewerbung zu.

Blog
NextLytics Newsletter
Abonnieren Sie jetzt unseren monatlichen Newsletter:
Newsletter abonnieren
 

Agentic AI im Data Engineering: Warum Architektur entscheidend ist

In einem früheren Artikel haben wir gezeigt, wie wir in Databricks einen KI-Agenten entwickelten, der Ihre Daten auswertet, Schlussfolgerungen daraus zieht und Ihnen Empfehlungen liefert, auf deren Grundlage Sie handeln können. In jenem Artikel ging es darum, wie man einen solchen Agenten aufbaut. In diesem Artikel geht es um die Frage, die sich für viele dann am nächsten Morgen stellt: Wo findet ein solcher Agent tatsächlich seinen Platz im Data-Engineering-Workflow, und was entscheidet darüber, ob er tatsächlich hilfreich ist oder nur noch schneller Chaos verursacht?

Stellen Sie sich den zweiten Fall vor: Ein Agent eröffnet über Nacht einen Pull-Request. Er hat eine Daten-Transformation umgestaltet und einen erfolgreichen Test hinzugefügt, und die Beschreibung liest sich gut. Außerdem hat er eine Spalte in einem Modell in „customer_id“ umbenannt, obwohl alle benachbarten Tabellen diese Spalte seit drei Jahren „cust_key“ heißen. Niemand hat dem Agenten mitgeteilt, dass diese Konvention existiert. Im Diff (Änderungsreport) ist nichts fehlerhaft. Dennoch gehört dies nicht in Ihre Plattform und ein Reviewer muss dies nun bemerken, bevor der Pull-Request gemergt wird. Multipliziert man das mit einer Woche mit von Agenten generierten Änderungen, wird das Ausmaß des Problems deutlich.

Was ist agentische KI-Automatisierung? Über die Autovervollständigung hinaus

Die sinnvolle Grenze verläuft zwischen einem einzelnen Modellaufruf und einem Agenten. Ein einzelner Aufruf nimmt eine Eingabe entgegen, gibt Text zurück (eine Vervollständigung, eine Zusammenfassung, eine Antwort in einem Chat-Fenster) und wartet dann auf dich. Ein Agent führt stattdessen eine Schleife aus. Er kann ein Schema lesen, eine Änderung vorschlagen, den Test für diese Änderung durchführen und den zurückgemeldeten Fehler nutzen, um einen anderen Ansatz zu versuchen, wobei er Tools aufruft und systemübergreifend agiert, bis er etwas erreicht, das er als abgeschlossen betrachtet.

Genau diese Schleife macht Agenten für die Datenarbeit so nützlich. Es bedeutet aber auch, dass ein unbegrenzter Agent irgendwann an einer Stelle agieren wird, an der Sie es nicht wollten; daher ist die Version, die sich in der produktiven Umgebung bewährt, eine begrenzte: Der Agent führt die mehrstufigen Arbeitsschritte innerhalb der von Ihnen festgelegten Grenzen durch, und ein Mensch gibt an den entscheidenden Punkten die Freigabe.

Top-Anwendungsfälle für AI-Engineering-Agenten in der Softwareentwicklung

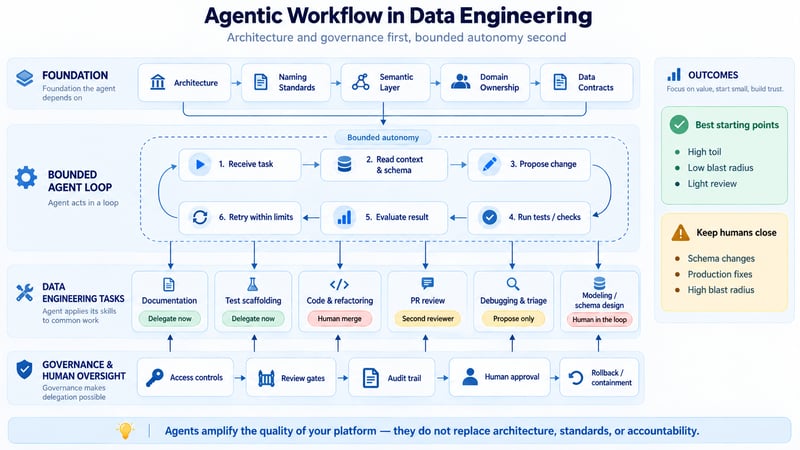
In einem typischen Data-Engineering-Workflow sind Agenten bereits bei einer Reihe von Aufgaben sehr leistungsfähig:

  • Dokumentation. Datenwörterbücher (data dictionaries), Spaltenbeschreibungen, Herkunftsübersichten und Runbook-Entwürfe, die nah am Code bleiben, anstatt in einem Wiki in Vergessenheit zu geraten.

  • Test- und Qualitätsgerüst. Die Umsetzung von Erwartungen in einen ersten Entwurf von Testfällen, Anomalieprüfungen und Validierungsregeln: ein Ausgangspunkt, den ein Entwickler verfeinert, noch nicht das letzte Wort.

  • Programmierung und Refactoring. Generierung von Transformationslogik, Übersetzung zwischen SQL-Dialekten und automatische Refactorings über viele Dateien hinweg gleichzeitig.

  • Review. Ein erster Durchlauf eines Diffs, der Anti-Patterns, Stilabweichungen und offensichtliche Performance- oder Governance-Probleme kennzeichnet, bevor sich ein menschlicher Reviewer damit befasst.

  • Debugging und Triage. Auswerten von Protokollen, Zurückverfolgen eines Fehlers bis zu seiner Ursache und Vorschlagen einer Korrektur, die von einer Person genehmigt oder freigegeben werden muss.

  • Modellierung. Profiling einer Datenquelle und Vorschlag eines Schemas, einer Normalisierungsentscheidung oder eines ersten Entwurfs für ein Dimensionsdesign. 
     

Typical_Data_Engineering_Workflow

Diese Tasks sind jedoch nicht gleichwertig. Dokumentation und Test - Gerüste lassen sich kostengünstig überprüfen und sind schwer zu korrumoieren; wenn ein Wörterbucheintrag falsch ist, korrigiert ihn jemand und sonst passiert kaum etwas. Eine Schemaänderung oder eine Korrektur in der Produktion birgt echte Nachteile: Der Arbeitsaufwand, den sie erspart, ist hoch, aber eine fehlerhafte Änderung breitet sich aus, bevor es jemand bemerkt. Wo eine Aufgabe auf diesem Spektrum angesiedelt ist und nicht, wie beeindruckend der Agent dabei wirkt, sollte darüber entscheiden, wie viel Spielraum man ihr einräumt.

Aufgabe Esparter Arbeitsaufwand Auswirkungsbereich bei Fehlern
Sofort delegieren?
Dokumentation Hoch Niedrig Ja, kurz prüfen
Testgerüst Hoch Niedrig Ja, ein Entwickler überprüft es
Code-Refactoring/ Dialektübersetzung Hoch Mittel Ja, mit einem Menschen beim Merge
PR-Review(erster Durchgang) Mittel Niedrig Ja, als zweiter Reviewer, nicht als einziger
Debugging / Triage

Hoch

Mittel Nur Vorschlag, Mensch genehmigt die Korrektur
Datenmodellierung / Schemaänderung Hoch Niedrig „Human-in-the-Loop"“ – immer

Sehen Sie sich die Aufzeichnung unseres Webinars an: "Bridging Business and Analytics: The Plug-and-Play Future of Data Platforms"

Warum Kontext und Systemarchitektur die Leistung von KI-Agenten bestimmen

Ein Agent ist nur so gut wie der Kontext, mit dem er arbeitet und auf einer Datenplattform besteht dieser Kontext größtenteils aus der Architektur. Namenskonventionen, Modellierungsstandards, ein semantischer Layer, der festlegt, was „Umsatz“ tatsächlich bedeutet, ein Verantwortlicher für jeden Bereich: Das sind die Faktoren, die es einem Agenten ermöglichen, etwas zu produzieren, das zum Rest der Plattform passt, anstatt nur für sich genommen korrekt zu sein. Nimmt man diese Struktur weg, produziert der Agent dennoch etwas. Er liefert selbstbewusste Ergebnisse, die für sich genommen gut lesbar sind, aber stillschweigend im Widerspruch zu allem um ihn herum stehen: die umbenannte Spalte, die Metrik, die auf eine vierte, andere Art berechnet wurde, die Tabelle, die in einem Modell normalisiert wurde, während drei andere sie absichtlich denormalisiert haben. Jede Änderung sieht für sich genommen vernünftig aus. Zusammen sind sie technische Schulden, die schneller entstehen, als ein Team von Menschen sie hätte schreiben können. Deshalb ist die Aussage „Ein Agent wird unsere chaotische Plattform aufräumen“ in ihrem Kausalzusammenhang verkehrt: Ein Agent verbraucht Struktur, er kann sie nicht erzeugen. Gibt man ihm eine gut modellierte, gut gesteuerte Plattform, verstärkt er gute Ingenieursarbeit. Gibt man ihm einen inkonsistenten Ausgangspunkt, erhält man diese Inkonsistenz in großem Maßstab zurück, was später mehr kostet, als es gekostet hätte, die Grundlage von vornherein richtig gestaltet zu haben.

Governance ist das, was Delegation möglich macht

Man kann nur eine Task delegieren, die man überprüfen, eindämmen und rückgängig machen kann - und genau deshalb ist Governance, die so oft als Bremse für Agenten betrachtet wird, das, was es einem tatsächlich ermöglicht, ihnen echte Arbeit zu übertragen. Zugriffskontrollen begrenzen, worauf ein Agent zugreifen kann. Datenverträge liefern ihm stabile Definitionen, auf deren Grundlage er arbeiten kann. Überprüfungsschritte stoppen plausible, aber falsche Ergebnisse, bevor sie veröffentlicht werden. Und wenn doch einmal etwas durchrutscht, zeigen ein Prüfpfad und klare Zuständigkeiten, was sich geändert hat und wer dafür verantwortlich ist. Ein Team, das diesen Grenzen vertraut, kann mehr an Agenten delegieren, gerade weil es weiß, wo die Grenzen liegen. Das ist auch der Grund, warum eine sinnvolle Einführung dem „Blast Radius“ folgt. Beginnen Sie dort, wo der Aufwand hoch und das Risiko gering ist (Dokumentation, Testgerüst, Erstprüfung), und lassen Sie die Agenten mit nur geringer menschlicher Einmischung arbeiten. Halten Sie die Mitarbeiter bei der Modellierung und allem, was in die produktive Umgebung gelangt, stets auf dem Laufenden. Messen Sie die Auswirkungen, anstatt sie anzunehmen und erweitern Sie dann die Autonomie eines Agenten, sobald Ihre Leitplanken und Ihr Vertrauen in ihn reifer werden. Wenn Sie die Ausgabe eines Agenten bei einer bestimmten Task noch nicht schnell und zuverlässig überprüfen können, ist dieser Task noch nicht bereit für die Übergabe; in den meisten Fällen ist das Hindernis eine Lücke in den Grundlagen und nicht eine Grenze des Agenten.

Auf dem Weg zur agentischen Governance: Unser Fazit

Agentische KI entwickelt sich zu einer echten Ebene oberhalb der modernen Datenplattform, und die Produktivitätsgewinne sind keineswegs hypothetisch. Sie wirkt jedoch wie ein Multiplikator, und ein Multiplikator spiegelt immer nur das wider, was man ihm vorgibt: gute Technik auf einer gut gesteuerten Plattform und jede bestehende Inkonsistenz auf einer instabilen Plattform - beides in vergrößertem Maßstab. Die Teams, die am meisten davon profitieren, sind nicht unbedingt die Early Adopters, sondern diejenigen, die zuerst die unscheinbare Arbeit geleistet haben (die Architektur, die Standards, die Governance) und dann den Agenten ermöglichen, darauf aufbauend schneller voranzukommen.  Agenten verändern das Tempo, nicht die Verantwortlichkeit: Die Definition von Qualität bleibt immer Aufgabe der Teams, nicht der KI.

Wenn Sie eine professionelle Einschätzung darüber wünschen, ob Ihre Datenplattform so aufgestellt ist, dass Sie Aufgaben sicher an Agenten delegieren können, besprechen wir das gerne mit Ihnen.

FAQ - Agenten-basierte KI im Data Engineering

Hier finden Sie einige der häufig gestellten Fragen zu Agentic AI im Data Engineering.

Was ist der Unterschied zwischen den KI-Assistenten, die wir bereits nutzen, und einem Agenten? Die pauschale Antwort lautet: Ein Assistent reagiert auf eine Anfrage und hört dann auf, während ein Agent plant, Tools einsetzt und systemübergreifend handelt, bis er ein Ziel erreicht hat. Der für ein Datenteam entscheidende Unterschied liegt darin, wo die Fehler landen. Eine falsche Antwort eines Assistenten bleibt im Chatfenster stehen, bis Sie entscheiden, was damit geschehen soll. Eine falsche Aktion eines Agenten hat bereits eine Tabelle, eine Pipeline oder einen Pull-Request beeinflusst. Deshalb lautet die relevante Frage zu einem Agenten weniger „Wie fähig ist er?“, sondern vielmehr „Was darf er erreichen?“.
Wir haben noch keine ausgereifte semantische Layer oder Namenskonventionen. Sollten wir mit dem Einsatz von Agenten erst einmal warten? Fangen Sie an, aber beginnen Sie dort, wo Ihre bestehende Arbeit bereits gut ist. Wenn ein Bereich gut modelliert und einheitlich benannt ist, setzen Sie den Agenten zunächst dort ein – zur Dokumentation oder zum Aufbau von Testgerüsten –, denn dort findet er ein klares Beispiel, an dem er sich orientieren kann. Gerade in den Ecken, in denen Ihre Standards lückenhaft sind, wird ein Agent seine überzeugendsten falschen Antworten liefern; daher sollten diese Bereiche als Letzte und nicht als Erste übergeben werden. Lassen Sie die Einführung Schritt für Schritt Ihrer Grundlage folgen, Domäne für Domäne.
Wird die Code-Review durch einen Agenten menschliche Reviewer ersetzen? Betrachten Sie sie als ersten Durchgang, nicht als endgültiges Urteil. Ein Agent ist gut darin, mechanische Probleme (Stilabweichungen, offensichtliche Anti-Pattern, eine Abfrage, die eindeutig zu viel abtastet) zu erkennen, bevor ein Mensch hinschaut. Was er nicht zuverlässig beurteilen kann, ist, ob eine Änderung zu Ihrer Architektur und Ihrer geschäftlichen Absicht passt – und genau dafür gibt es die menschliche Überprüfung. Bei richtiger Nutzung bedeutet dies, dass sich Ihre Prüfer auf die Ermessensentscheidungen konzentrieren können, anstatt auf fehlende Semikolons.
Wird Governance die Einführung von Agenten nicht verlangsamen? Sie ist in der Regel genau das, was eine sichere Einführung ermöglicht. Versuchen Sie einmal, eine konkrete Frage zu beantworten: „Welcher Agent hat diese Tabelle im letzten Quartal geändert, und in wessen Auftrag?“, ohne Zugriffskontrollen und einen Prüfpfad – und Sie werden feststellen, dass Sie Agenten nicht in die Nähe von irgendetwas lassen können, das von Bedeutung ist. Die Teams, die am meisten delegieren, sind in der Regel diejenigen, die frühzeitig in Governance investiert haben, da sie darauf vertrauen können, was der Agent tun darf und was nicht.
Woher wissen wir, ob Agenten tatsächlich helfen? Beobachten Sie, wohin sich der Aufwand verlagert, und nicht, wie viel Output entsteht. Die entscheidende Kennzahl ist, wie oft die Ergebnisse eines Agenten ohne Nachbearbeitung akzeptiert werden: Ist diese Quote niedrig, verbringen die Mitarbeiter ihre eingesparte Zeit damit, den Agenten zu korrigieren. Neben dieser Kennzahl lohnt es sich, auch die Überprüfungszeit und die Störfallraten zu verfolgen. Ein hohes Volumen an vom Agenten generierten Änderungen bei einer niedrigen Akzeptanzquote ist keine Produktivität: Es bedeutet in der Regel, dass der Kontext, in dem der Agent arbeiten muss, für die ihm übertragene Task zu dünn ist.
Auf welchen Agenten oder welches Tool sollten wir standardisieren? Dies ist weniger entscheidend, als die Anbieter Ihnen glauben machen möchten, da die Fähigkeit „Planen – Aufrufen – Tools – Handeln“ auf den großen Plattformen und in offenen Frameworks zunehmend Standard wird. Wenn Sie sich entscheiden, wägen Sie die Aspekte ab, die Ihre Grundlagen betreffen: Wie gut werden Ihre Zugriffskontrollen berücksichtigt, wie nachvollziehbar sind die Aktionen im Nachhinein und wie nahtlos fügt sich das Tool in Ihren bestehenden Katalog und Ihren Überprüfungsprozess ein? Diese Faktoren entscheiden darüber, ob der Agent im Rahmen Ihrer Governance arbeitet oder diese umgeht – was wichtiger ist als jede Benchmark-Bewertung.

,

avatar

Apostolos Kouzoukos

Apostolos ist seit 2022 als Data Engineering Consultant für die NextLytics AG tätig. Er verfügt über Erfahrung in Forschungsprojekten zu Deep-Learning-Methoden und deren Anwendungen im Fintech-Bereich sowie über einen Hintergrund in der Backend-Entwicklung. In seiner Freizeit spielt er gerne Gitarre und hält sich mit den neuesten Nachrichten aus den Bereichen Technologie und Wirtschaft auf dem Laufenden.

Sie haben eine Frage zum Blog?
Fragen Sie Apostolos Kouzoukos

Gender Hinweis Aufgrund der besseren Lesbarkeit wird im Text das generische Maskulinum verwendet. Gemeint sind jedoch immer alle Menschen.
Agentic AI im Data Engineering: Warum Architektur entscheidend ist
9:24

Blog - NextLytics AG 

Welcome to our blog. In this section we regularly report on news and background information on topics such as SAP Business Intelligence (BI), SAP Dashboarding with Lumira Designer or SAP Analytics Cloud, Machine Learning with SAP BW, Data Science and Planning with SAP Business Planning and Consolidation (BPC), SAP Integrated Planning (IP) and SAC Planning and much more.

Informieren Sie mich über Neuigkeiten

Verwandte Beiträge

Letzte Beiträge

Beiträge nach Themen